9 de septiembre de 2026
Koha ahora entiende el texto manuscrito
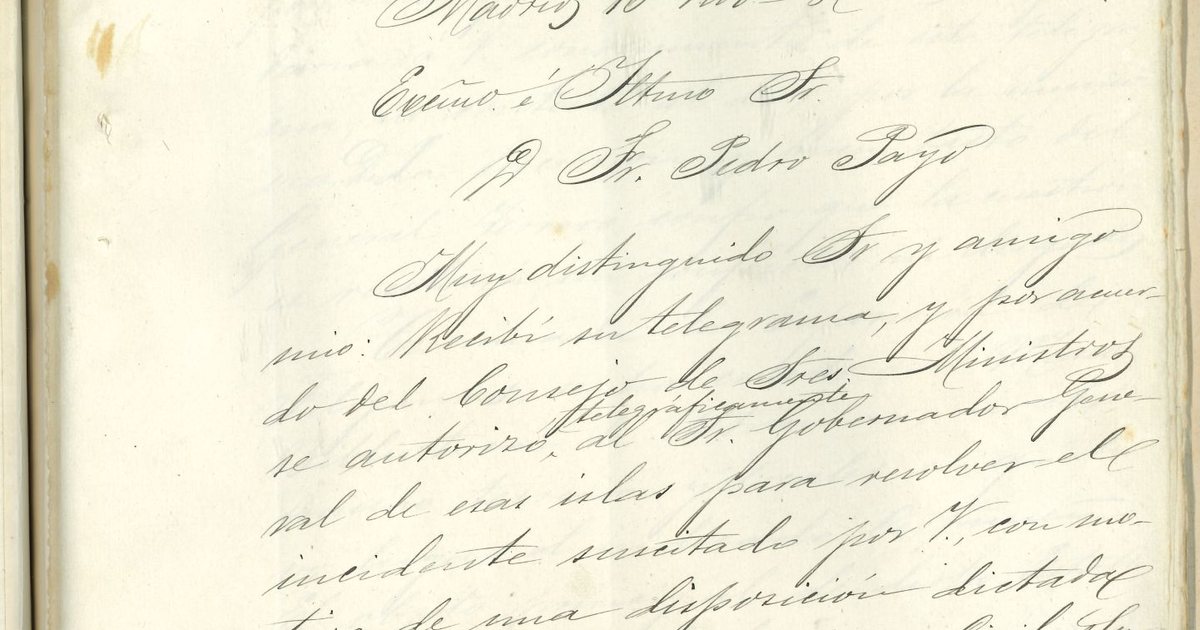
Un fondo digitalizado es, para el catálogo, una colección de fotografías: se ven, pero no se buscan. Quien quiere encontrar un documento por algo que dice dentro no lo encuentra, porque ese texto no existe en ninguna parte del sistema. Ya podemos crearlo: transcribimos el manuscrito con IA y lo metemos dentro de Koha, con su resumen, sus palabras clave y un visor que sabe dónde está cada línea.
Lo primero: encontrar las líneas
Antes de leer nada hay que saber dónde está escrito. Cada recuadro es una línea detectada sobre la imagen real, con sus coordenadas.

Carta de noviembre de 1887. Las once líneas, delimitadas automáticamente; en rojo, la que contiene «Ministros».
Y luego: leerlas
El texto queda ligado a esas coordenadas, así que se puede enseñar al lado de la imagen y resaltar la misma línea en los dos sitios a la vez.
Cómo queda el registro
Todo se incrusta en el propio registro bibliográfico y se indexa. No hay una herramienta aparte que mantener.
Las cuatro piezas
- Transcripción del manuscrito. Con un modelo de visión, no con un OCR clásico: el OCR sirve para texto impreso y fracasa con la letra a mano.
- Resumen automático de dos o tres líneas por documento —remitente, destinatario, fecha y asunto—, en el campo de resumen del registro.
- Palabras clave: personas, lugares e instituciones citados. Entran en el índice de materias que Koha ya tiene, así que se vuelven enlaces que agrupan el fondo por lo que menciona. Es el índice onomástico que con decenas de miles de documentos nadie iba a hacer a mano.
- Visor con zoom y coordenadas, dentro de la ficha, junto al visualizador de imágenes de siempre y sin sustituirlo.
Qué hace falta para empezar
Poco: treinta imágenes representativas del fondo y sus transcripciones de referencia hechas por el archivo. Nada más — el piloto no necesita tocar el servidor de nadie, porque treinta ficheros caben en un correo. Lo que sale es una tabla con el error medido por motor y una decisión con datos, no con intuición.
¿Tienes fondo manuscrito digitalizado?
Te decimos qué daría en tu caso antes de que te comprometas a nada.
Escríbenos y hacemos el piloto